
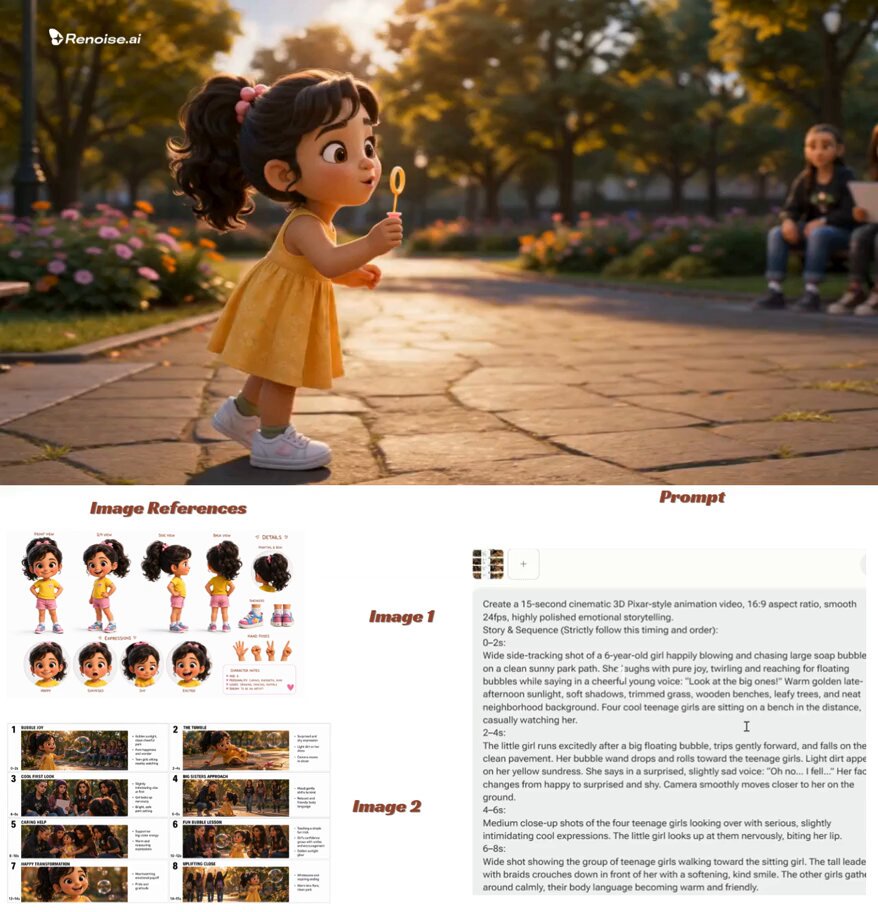
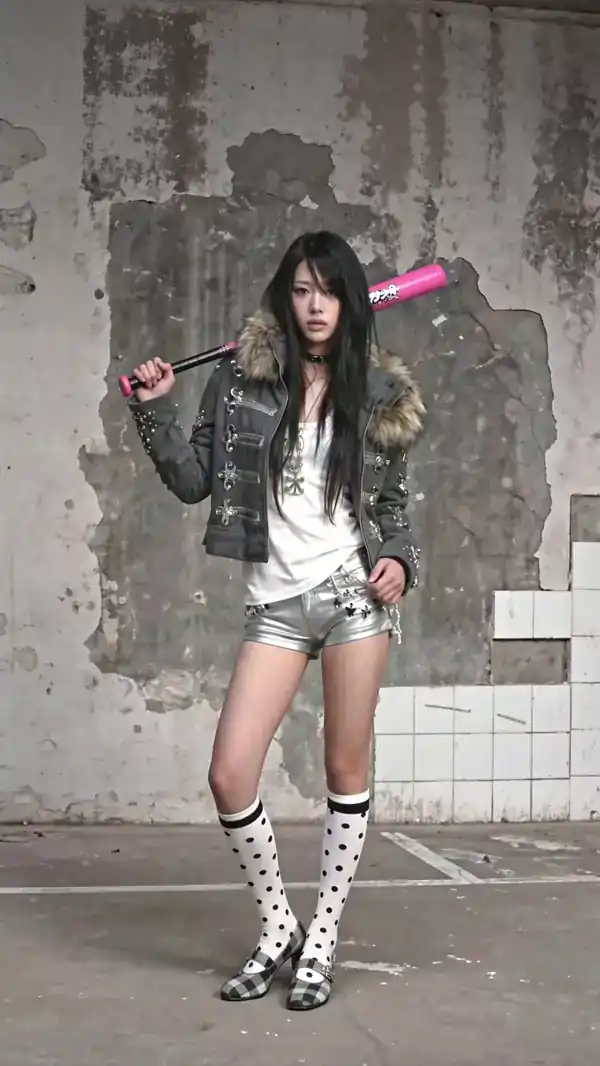
Czym jest generowanie wideo z obrazu i kiedy ma sens
Generowanie wideo z obrazu, nazywane też obrazem na wideo, to proces, w którym model generatywny otrzymuje jeden lub kilka statycznych kadrów i tworzy na ich podstawie spójną sekwencję ruchomych klatek. Zamiast opisywać całą scenę słowami od zera, twórca startuje od gotowego kompozycyjnie materiału — zrzutu ekranu interfejsu, mockupu produktu, ilustracji postaci, zdjęcia plenerowego — i wskazuje, co ma się w nim wydarzyć.
To odwrócenie typowego porządku pracy. W klasycznym podejściu najpierw powstaje scenariusz, potem storyboard, potem animacja. Tutaj punktem wyjścia jest obraz, który już istnieje i już działa wizualnie. Model ma dodać czas: ruch kamery, drobne gesty, zmianę światła, przesuwające się tło.
Typowe scenariusze, w których to podejście wygrywa
- Reklama produktu. Statyczne zdjęcie lub render trafia do modelu, a wynikiem jest krótki, płynny najazd kamery z delikatnym rozmyciem tła. Efekt wygląda jak materiał z planu zdjęciowego, choć nigdy nie powstał fizycznie.
- Social media. Pojedynczy kadr z kampanii zamienia się w pętlę o długości kilku sekund, która przyciąga wzrok w przewijaniu.
- Prototypowanie. Reżyser lub projektant sprawdza, jak dana kompozycja zachowuje się w ruchu, zanim zainwestuje czas w pełną produkcję.
- Animacja stylizowana. Ilustracja lub kadr w konwencji anime przechodzi w serię szybkich cięć i dynamicznych przejść, budując wrażenie sceny akcji.
- Materiały do prezentacji i szkoleń. Zrzut ekranu interfejsu ożywa, pokazując przepływ kliknięć bez nagrywania prawdziwego pulpitu.
Kiedy lepiej tego nie robić
Jeśli potrzebujesz precyzyjnej animacji technicznej zgodnej z dokumentacją — na przykład ruchu wahacza zawieszenia — generowanie wideo jest złym narzędziem. Model odtwarza prawdopodobny ruch, nie ruch poprawny fizycznie. Podobnie w sytuacjach, gdzie liczy się wierność twarzy konkretnej osoby lub czytelność drobnego tekstu w kadrze: przy dłuższych klipach łatwo o dryf szczegółów.
Fundament techniczny: jak model zamienia piksele w ruch
Warto rozumieć mechanizm, bo od niego zależą wszystkie decyzje praktyczne — od wyboru rozdzielczości wejścia po długość promptu.
Od klatki kluczowej do sekwencji
Współczesne modele obrazu na wideo najczęściej bazują na architekturze dyfuzyjnej rozszerzonej o wymiar czasu. Obraz wejściowy jest kodowany do reprezentacji latentnej, a następnie model odszumia kolejne klatki, korzystając z warunku w postaci tego obrazu. Klatka pierwsza pozostaje zwykle najbliższa oryginałowi — to ona stabilizuje kompozycję. Im dalej od początku, tym większa swoboda modelu i tym większe ryzyko rozjazdu z intencją twórcy.
Dlatego praktyczna zasada brzmi: im krótszy klip, tym większa kontrola. Sekwencje dwu-, trzysekundowe utrzymują spójność niemal idealnie. Przy dziesięciu sekundach trzeba już aktywnie zarządzać ruchem i nie oczekiwać, że model sam utrzyma detale.
Spójność postaci i środowiska między kadrami
Największym wyzwaniem w generowaniu wideo jest tak zwana spójność między klatkami. Model musi pamiętać, że ta sama twarz, ten sam kolor kurtki i ten sam układ cieni obowiązują przez cały czas trwania ujęcia. Typowe objawy problemu to:
- zmiana rysów twarzy przy skręcie głowy,
- rozjeżdżanie się liczby palców,
- „oddychające” tło, w którym architektura delikatnie się deformuje,
- zmiana faktury materiału, na przykład z matowej na połyskującą,
- przesuwanie się logotypu lub napisu w obrębie kadru.
Sposoby ograniczania tych efektów są dobrze znane w praktyce: krótsze klipy, mniejsza amplituda ruchu, maskowanie obszarów, które mają pozostać nieruchome, praca na wyższej rozdzielczości wejścia i dzielenie sceny na kilka ujęć zamiast jednego długiego.
Kontrola ruchu: kamera, obiekt, tempo
Trzy osie, które trzeba świadomie ustawić:
- Ruch kamery — najazd, odjazd, panoramowanie, orbita, ujęcie z drona, statyw z lekkim drżeniem.
- Ruch obiektu — gest ręki, obrót produktu, opadanie liści, przemieszczanie się postaci w kadrze.
- Tempo — czy scena ma być spokojna i obserwacyjna, czy energiczna, z cięciami i przyspieszeniami.
Modele różnią się pod tym względem. Jedne lepiej rozumieją polecenia dotyczące kamery, inne mocniej trzymają się geometrii obiektu, jeszcze inne są zoptymalizowane pod szybkie, stylizowane cięcia. Świadomość profilu narzędzia oszczędza wiele iteracji.
Przygotowanie materiału źródłowego
Jakość wyniku w ogromnej mierze zależy od jakości wejścia. Obraz, który jest nieostry, przepełniony szumem albo ma przypadkowe elementy interfejsu, będzie generował równie przypadkowy ruch.
Rozdzielczość, proporcje i czystość krawędzi
Minimum to zwykle 1024 piksele na krótszym boku, a komfort pracy zaczyna się przy 1920. Proporcje powinny odpowiadać docelowemu formatowi: pion 9:16 do krótkich form, poziom 16:9 do prezentacji i YouTube, kwadrat do niektórych kanałów społecznościowych. Zmiana proporcji po wygenerowaniu oznacza przycinanie, a przycinanie często ucina elementy, które model zdążył rozciągnąć poza kadr.
Krawędzie obiektów warto wyczyścić przed wysłaniem obrazu. Model potrafi potraktować rozmyty brzeg jako zaproszenie do ruchu i „rozmazać” kontur w pierwszych klatkach.
Warstwy semantyczne: co ma się ruszać, a co nie
Przed generowaniem dobrze jest rozpisać obraz na warstwy znaczeniowe:
- warstwa stała — tło architektoniczne, logotyp, statyczny interfejs,
- warstwa ruchoma — postać, pojazd, produkt,
- warstwa atmosferyczna — dym, mgła, deszcz, iskry, światło przechodzące przez żaluzje,
- warstwa kamery — to, co robi z kadrem operator.
Jeśli umiesz te elementy nazwać, prompt praktycznie pisze się sam. Jeśli nie umiesz, prompt będzie ogólnikowy, a wynik losowy.
Struktura promptu do obrazu na wideo
Prompt w tym trybie jest inny niż w generowaniu obrazu z tekstu. Nie opisujesz całej sceny od podstaw, bo scena już istnieje. Opisujesz zmianę w czasie.
Sprawdzony szkielet
[obiekt] + [akcja] + [ruch kamery] + [tempo] + [światło i atmosfera] + [styl i technika]
Przykład dla mockupu aplikacji:
Pulpit aplikacji finansowej; wykresy delikatnie się aktualizują, jedna karta przewija się w górę; powolny najazd kamery od lewej do prawej; spokojne tempo; chłodne światło biurowe z miękkim odbiciem na ekranie; czysty, nowoczesny styl produktowy, ostre krawędzie interfejsu.
Przykład dla ilustracji w konwencji animowanej:
Postać w płaszczu na dachu; płaszcz faluje na wietrze, włosy unoszą się ku górze; kamera lekko się podnosi i przechyla; tempo średnie, jak w dynamicznym cięciu; zachodzące słońce, długie cienie; styl malarski, wyraźne kontury, ziarno filmowe.
Parametry negatywne i pułapki językowe
Lista wykluczeń działa tu równie dobrze jak przy generowaniu obrazu: rozmycie ruchu, zniekształcone dłonie, dodatkowe kończyny, zmiana twarzy, migotanie, nakładające się napisy, artefakty kompresji, deformacja tła.
Uwaga na dwa typowe błędy:
- Zbyt wiele poleceń naraz. Pięć niezależnych ruchów w jednym ujęciu niemal zawsze kończy się chaosem. Lepiej podzielić scenę na dwa krótkie klipy i zmontować je później.
- Opisywanie rzeczy, która już jest w obrazie. Powtarzanie detali z kadru zabiera modelowi uwagę, którą powinien poświęcić na ruch.
Wybór narzędzia: kryteria zamiast mody
Rynek narzędzi do generowania wideo zmienia się szybciej niż jakikolwiek inny obszar AI, więc zamiast śledzić rankingi, warto znać kryteria dopasowania do zadania. Narzędzia takie jak Runway, Luma, Kling, Pika, Vidu czy modele w rodzaju Sory traktuj jako różne profile pracy, a nie jako zestaw „najlepszych”.
Pięć pytań przed wyborem
- Jaki jest dopuszczalny czas jednego ujęcia? Jeśli 3–5 sekund, wybór jest szeroki. Jeśli 10 sekund i więcej, zawęża się do modeli lepiej utrzymujących spójność.
- Czy potrzebujesz precyzyjnej kamery? Jeśli tak, sprawdź, czy narzędzie pozwala sterować kierunkiem i prędkością ruchu kamery, a nie tylko opisać go słowami.
- Czy w kadrze są twarze? Twarze to najtrudniejszy element. Przetestuj konkretny przypadek przed produkcją.
- Czy materiał musi pozostać prywatny? Wtedy rozważ pipeline lokalny: ComfyUI, AnimateDiff, modele dyfuzyjne uruchamiane na własnej karcie graficznej.
- Ile wariantów wygenerujesz w jednej sesji? Liczba prób bywa ważniejsza niż jakość pojedynczego wyniku — czasem lepiej mieć dziesięć średnich ujęć niż jedno idealne.
Chmura czy środowisko lokalne
| Kryterium | Narzędzie chmurowe | Pipeline lokalny |
|---|---|---|
| Próg wejścia | Niski | Wysoki |
| Kontrola nad modelem | Ograniczona | Pełna |
| Powtarzalność | Zależna od wersji | Pełna, jeśli zapiszesz konfigurację |
| Prędkość na starcie | Wysoka | Zależna od sprzętu |
| Prywatność materiałów | Zależna od regulaminu | Pełna |
W praktyce wiele zespołów pracuje hybrydowo: szybkie testy koncepcji w chmurze, finalne ujęcia w pipeline, który można odtworzyć i zapisać.
Praktyczny workflow: od zrzutu ekranu do gotowego klipu
Poniższy przebieg sprawdza się zarówno przy animowaniu interfejsu, jak i przy ilustracji czy zdjęciu produktowym.
Krok 1: Zdefiniuj jedno zdanie celu
Zapisz, co widz ma zapamiętać po trzech sekundach. „Nowoczesna aplikacja, która działa płynnie” to nie cel. „Ekran, na którym wykres rośnie, a kamera powoli się cofa, pokazując spokój i kontrolę” — to cel.
Krok 2: Przygotuj klatkę wejściową
Wyrównaj horyzont, wyczyść krawędzie, usuń zbędne elementy interfejsu, ustal docelowe proporcje. Zapisz wersję roboczą w wysokiej jakości — to ona posłuży za punkt odniesienia przy ocenie wyników.
Krok 3: Napisz prompt w szablonie
Użyj szkieletu obiekt–akcja–kamera–tempo–światło–styl. Trzymaj się jednego akapitu, maksymalnie dwóch. Dopisz listę wykluczeń.
Krok 4: Wygeneruj serię wariantów
Zamiast oceniać pojedynczy wynik, wygeneruj od czterech do ośmiu propozycji przy tych samych ustawieniach. Różnice między nimi pokażą, które elementy są stabilne, a które model interpretuje losowo. To najszybszy sposób zrozumienia profilu narzędzia.
Krok 5: Oceń według stałej listy
- Czy pierwsza klatka zgadza się z materiałem źródłowym?
- Czy ruch jest płynny na całej długości?
- Czy twarze, dłonie i napisy przetrwały?
- Czy tło nie „oddycha”?
- Czy ruch kamery wspiera przekaz, czy tylko go zdobi?
Krok 6: Popraw przez uproszczenie
Jeśli wynik jest chaotyczny, nie dodawaj poleceń — usuń jedno. W dziewięciu przypadkach na dziesięć problem wynika z nadmiaru intencji, nie z braku szczegółów.
Krok 7: Zmontuj i wygładź
Złóż ujęcia w edytorze (DaVinci Resolve, Premiere, After Effects), dodaj krótkie przejścia, dopasuj kolor i — jeśli to potrzebne — interpoluj klatki, aby uzyskać płynność 60 fps z materiału 24 fps. Delikatne wygładzenie i redukcja szumu potrafią uratować ujęcie, które w surowej formie wygląda sztucznie.
Krok 8: Zarchiwizuj konfigurację
Zapisz obraz wejściowy, prompt, ustawienia i numer wersji modelu. Bez tego nie odtworzysz wyniku za miesiąc, gdy okaże się, że klient chce „jeszcze jedną wersję tamtego ujęcia”.
Typowe błędy i sposoby ich naprawy
Rozmycie i migotanie
Najczęstsza przyczyna to zbyt duża amplituda ruchu względem rozdzielczości. Rozwiązanie: zmniejsz zakres ruchu, podnieś rozdzielczość wejścia, skróć klip.
Deformacje twarzy i dłoni
Twarz i dłoń to obszary o najwyższej złożoności anatomicznej. Jeśli postać ma być widoczna z bliska, rozważ ujęcie z odwróconą głową, dłońmi poza kadrem albo przejście w stylizację, która maskuje drobne błędy. Alternatywnie wygeneruj ujęcie szerokie i buduj emocję ruchem kamery, nie mimiką.
Dryf kompozycji
Model powoli „odjeżdża” od pierwotnego kadru, aż po ośmiu sekundach scena wygląda jak zupełnie inna. Lekarstwo: krótsze ujęcia sklejane cięciem. Widz nie zauważy cięcia, jeśli rytm jest poprawny, a zauważy rozpad obrazu.
Nadużywanie ruchu
Ruch w każdym kierunku naraz to najszybsza droga do efektu taniości. Wybierz jedną dominantę: albo kamera, albo obiekt. Drugi element niech pozostanie niemal statyczny.
Ignorowanie montażu
Pojedyncze wygenerowane ujęcie rzadko jest gotowym materiałem. Wartość powstaje w montażu: rytmie, kontraście ujęć szerokich i bliskich, zmianie tempa. Generator dostarcza cegły, nie budynek.
Jakość, długość i powtarzalność: kryteria decyzyjne
Jak długie ujęcia planować
Przyjmij roboczą zasadę: 2–4 sekundy na jedno wygenerowane ujęcie, potem cięcie. To zakres, w którym większość modeli utrzymuje spójność bez dodatkowych zabiegów. Ujęcia dłuższe są możliwe, ale wymagają więcej prób i zwykle i tak kończą się przycinaniem w montażu.
Ile wariantów potrzebujesz
Na każde ujęcie w finalnym montażu zaplanuj od sześciu do dwunastu prób. Brzmi dużo, ale selekcja jest częścią procesu twórczego, nie marnotrawstwem. Profesjonalne podejście polega na generowaniu szeroko i wybieraniu wąsko.
Kiedy powtórzyć, a kiedy zmienić kierunek
Jeśli trzy kolejne próby mają ten sam błąd, problem leży w materiale wejściowym lub w promptcie, nie w losowości. Wróć do kroku drugiego. Jeśli błędy są różne i losowe, po prostu generuj dalej — to normalna wariancja modelu.
Kontrola jakości w zespole
Ustal jedną, krótką listę kryteriów akceptacji i trzymaj się jej przy każdej iteracji. Zespoły, które oceniają materiał „na wyczucie”, tracą czas na dyskusje o preferencjach zamiast o błędach technicznych.
Prawa, etyka i materiał źródłowy
Generowanie wideo z obrazu podnosi kilka praktycznych kwestii, o których łatwo zapomnieć w ferworze pracy.
- Prawa do obrazu wejściowego. Animowanie cudzego zdjęcia nie czyni go twoim. Sprawdź licencję materiału źródłowego, zanim użyjesz go komercyjnie.
- Wizerunek osób. Jeśli w kadrze znajduje się rozpoznawalna osoba, potrzebujesz zgody na wykorzystanie jej wizerunku — także wtedy, gdy twarz została wygenerowana na podstawie zdjęcia.
- Materiały wewnętrzne. Zrzuty ekranu z systemów firmowych mogą zawierać dane osobowe lub informacje poufne. Zanim wyślesz je do zewnętrznego narzędzia, zanonimizuj interfejs: zamień nazwiska, identyfikatory i liczby na dane przykładowe.
- Oznaczanie treści. W wielu kanałach i platformach warto jasno komunikować, że materiał powstał z użyciem AI. Buduje to zaufanie i chroni przed nieporozumieniami.
- Spójność z marką. Wygenerowany ruch powinien odpowiadać tonowi komunikacji. Dynamiczne, agresywne cięcia nie pasują do marki, która komunikuje spokój i zaufanie.
FAQ: najczęstsze pytania o obraz na wideo
Czy jeden obraz wystarczy, żeby wygenerować sensowne ujęcie?
Tak, jeden dobrze przygotowany kadr to najczęstszy punkt startowy. Dwa lub trzy powiązane kadry dają większą kontrolę nad kompozycją w czasie, ale wymagają więcej pracy przygotowawczej.
Dlaczego moje ujęcia tracą ostrość po trzeciej sekundzie?
Najprawdopodobniej model dryfuje kompozycyjnie. Skróć ujęcie, zmniejsz amplitudę ruchu, podnieś rozdzielczość wejścia i rozważ podzielenie sceny na dwa krótsze klipy.
Jak uzyskać efekt ręcznej kamery?
Opisz go wprost jako sposób prowadzenia kamery, a nie jako „nieostrość”. Polecenia typu „statyw z lekkim drżeniem operatora” działają lepiej niż „rozmycie ruchu”.
Czy da się wygenerować czytelny tekst w kadrze?
Krótkie napisy w pierwszych klatkach bywają czytelne, ale przy dłuższych ujęciach litery się deformują. Bezpieczniej dodawać tekst w montażu, na gotowym materiale.
Ile czasu zajmuje cały proces od zrzutu ekranu do gotowego klipu?
Przy prostym ujęciu produktowym realne jest 45–90 minut, wliczając przygotowanie obrazu, kilka rund generowania, selekcję i montaż. Bardziej złożone sceny z postaciami wymagają kilku godzin.
Czy wygenerowany materiał nadaje się do reklamy płatnej?
Tak, pod warunkiem że masz prawa do materiału wejściowego, sprawdziłeś regulamin narzędzia i zweryfikowałeś wynik pod kątem artefaktów. Wielu twórców używa generowanych ujęć jako elementów większego montażu, a nie jako całości reklamy.
Co zrobić, gdy model ignoruje polecenie ruchu kamery?
Uprość prompt do jednej dominanty i usuń pozostałe. Jeśli to nie pomaga, zmień narzędzie — profile modeli różnią się pod tym względem znacznie bardziej, niż sugerują ogólne porównania.
Co dalej: praktyczny plan na pierwszy tydzień
Najlepszym sposobem nauki jest seria małych, zamkniętych eksperymentów. Wybierz jeden obraz — na przykład zrzut ekranu własnego projektu — i wykonaj na nim pięć testów: spokojny najazd, odjazd, panoramowanie, ruch obiektu bez ruchu kamery oraz scenę z atmosferą, taką jak mgła czy deszcz. Oceń każdy wynik według tej samej listy kryteriów i zapisz wnioski.
Drugi tydzień poświęć na montaż. Sklej najlepsze ujęcia w piętnastosekundową sekwencję z muzyką i sprawdź, czy rytm działa. Trzeci tydzień to praca z powtarzalnością: zapisz prompty, ustawienia i wersje modeli tak, abyś po miesiącu mógł odtworzyć dowolny wynik.
Generowanie wideo z obrazu nie zastępuje rzemiosła filmowego — przenosi je w nowe miejsce. Kompozycja, rytm, światło i decyzja o tym, co ma się poruszyć, pozostają po stronie twórcy. Model odpowiada wyłącznie za wykonanie ruchu. Im jaśniej określisz ten ruch, tym mniej razy będziesz zaczynać od nowa — i tym szybciej pojedynczy zrzut ekranu stanie się pełnoprawnym ujęciem w gotowej produkcji.
