
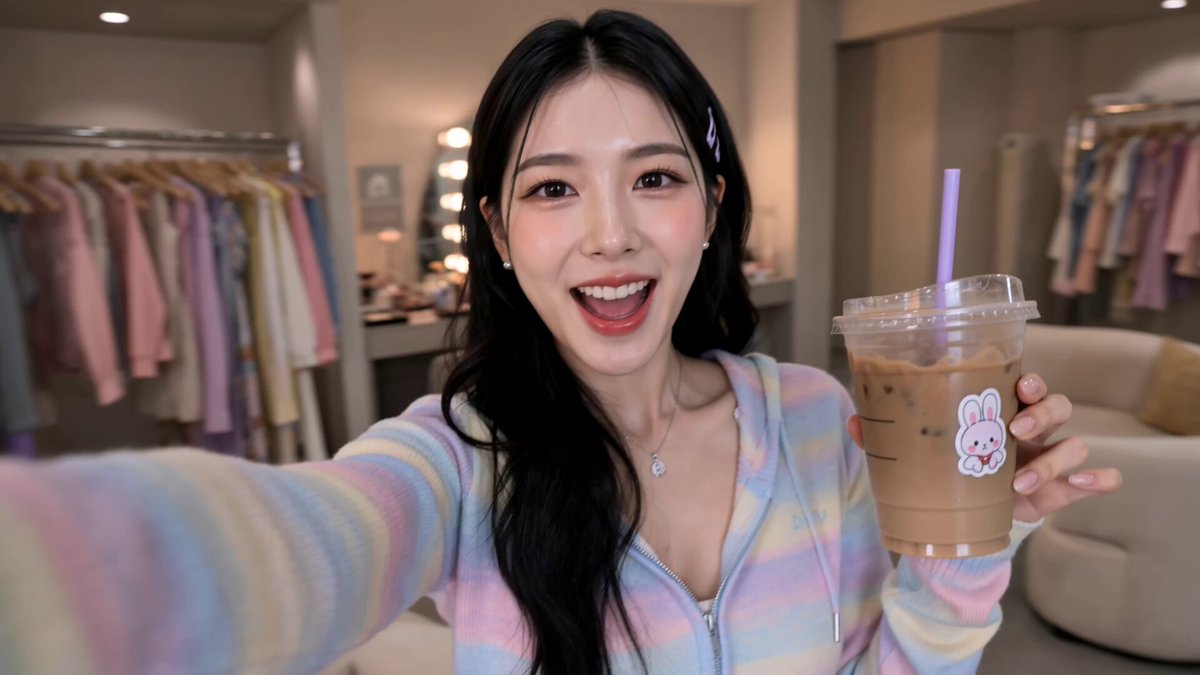
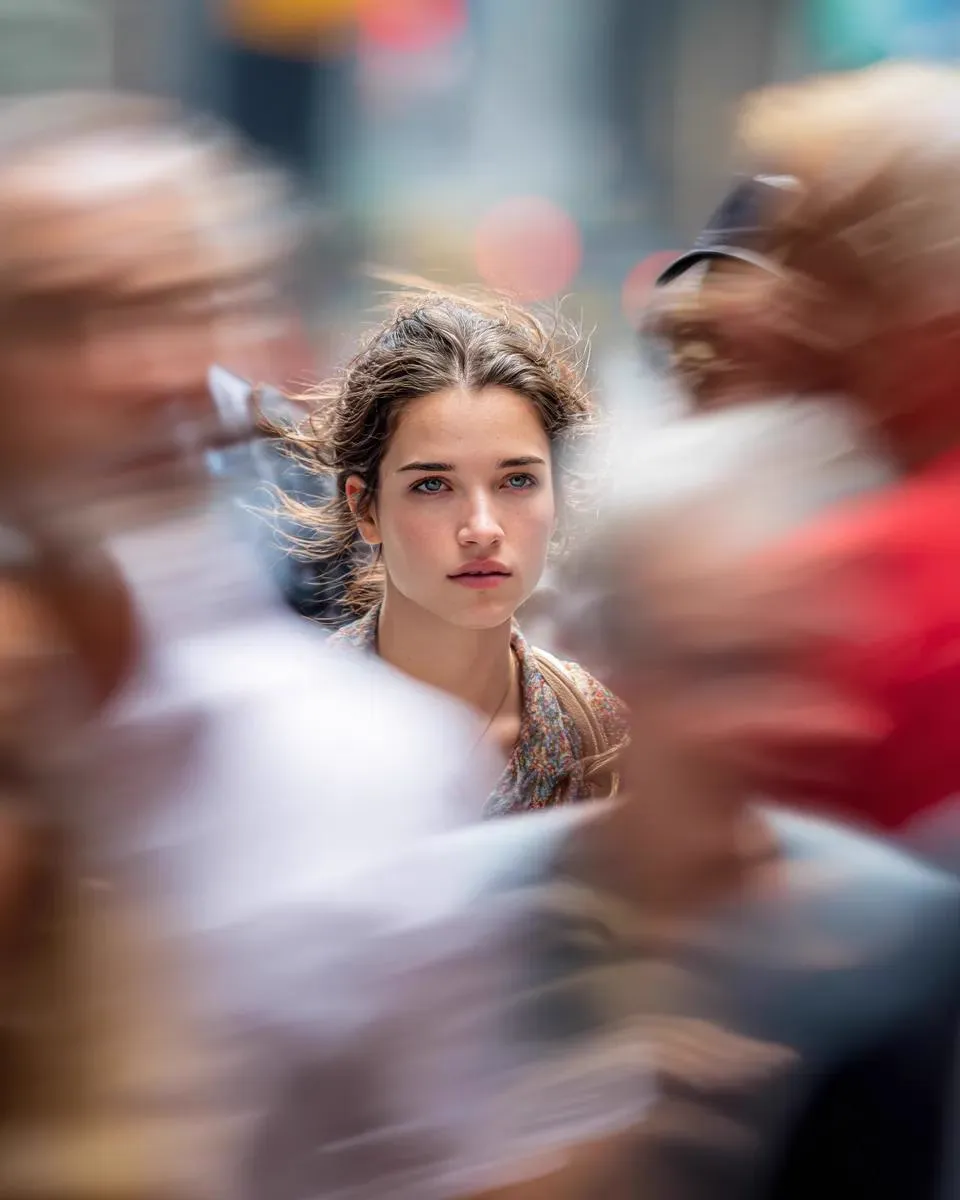
Manter o mesmo rosto, o mesmo figurino e o mesmo tom ao longo de dezenas de cenas deixou de ser privilégio de estúdios com equipe grande. Com os modelos generativos atuais, é possível construir um personagem digital, reutilizá-lo em cenários completamente diferentes e manter a identidade visual reconhecível do primeiro ao último segundo. O obstáculo deixou de ser gerar uma imagem bonita: agora é gerar a mesma pessoa, repetidamente, com controle suficiente para editar, corrigir e escalar.
Este guia percorre o fluxo completo — da ficha visual do personagem à montagem final — com critérios de decisão, exemplos práticos, erros frequentes e ajustes que realmente mudam o resultado.
Por que a consistência virou o principal gargalo
A primeira geração de ferramentas de vídeo com IA encantou pela novidade: clipes curtos, movimento plausível, texturas surpreendentes. O problema aparecia na segunda cena. O cabelo mudava de comprimento, a jaqueta trocava de cor, o formato do rosto derivava alguns milímetros a cada nova geração. Para um teste isolado, isso passava. Para uma série, um anúncio com múltiplas cenas ou uma narrativa de dois minutos, a inconsistência destrói a credibilidade em poucos segundos.
Esse gargalo é técnico, mas também perceptivo. O cérebro humano é extraordinariamente sensível a detalhes faciais. Reconhecemos uma pessoa em milissegundos e notamos desvios mínimos de proporção entre olhos, nariz e queixo, mesmo sem saber nomear o que mudou. É por isso que um clipe pode parecer tecnicamente impecável e ainda assim soar "errado": o espectador não vê o defeito de renderização, vê a troca de identidade.
A resposta da indústria veio em três frentes: referências múltiplas por geração, controle explícito de keyframes e mecanismos de ancoragem de identidade que viajam de cena em cena. Entender como essas três peças se combinam é o que separa um experimento curioso de um pipeline de produção confiável.
O que significa fusionar imagens na prática
"Fusionar imagens" não é apenas sobrepor duas fotos. No contexto de vídeo generativo, significa combinar fontes distintas — retratos, referências de estilo, elementos de cenário — em uma única composição coerente, onde cada fonte contribui com uma camada de informação diferente. Um rosto fornece identidade. Uma foto de corpo inteiro fornece proporção e postura. Uma imagem de referência de figurino fornece tecido, cor e caimento. Um cenário fornece luz e atmosfera.
O ponto crítico é a hierarquia. Quando duas referências competem pela mesma decisão visual — por exemplo, duas imagens com iluminação oposta — o modelo tende a produzir um híbrido instável que muda entre gerações. A fusão funciona bem quando cada referência tem uma função clara e não invade a função das outras.
Referência única versus referências múltiplas
Usar uma única imagem de referência é rápido e previsível, mas limita o repertório de poses e ângulos. O modelo aprende uma aparência e a replica, muitas vezes congelando a expressão e a luz da referência original. Isso serve para planos frontais e conteúdo de apresentador, mas quebra quando o personagem precisa correr, virar de costas ou ser filmado em contraluz.
Referências múltiplas resolvem esse limite, mas exigem curadoria. O conjunto ideal costuma ter quatro a seis imagens do mesmo personagem: um retrato frontal com luz neutra, um perfil de três quartos, um plano aberto de corpo inteiro, uma expressão secundária e, se houver figurino recorrente, uma referência específica da roupa. Imagens contraditórias — maquiagem diferente, idade aparente distinta, iluminação extrema — pioram o resultado em vez de enriquecê-lo.
Camadas de identidade: rosto, silhueta, figurino e paleta
Trate a identidade como um sistema de camadas. A camada facial é a mais sensível e deve vir de referências nítidas, com o rosto ocupando boa parte do quadro e sem filtros pesados. A camada de silhueta define proporção, altura de ombros, formato de cabelo e postura. A camada de figurino estabelece paleta e textura. A camada de paleta geral amarra tudo com uma temperatura de cor consistente.
Quando um plano quebra, identifique qual camada falhou antes de reescrever o prompt inteiro. Muitas vezes o problema está apenas na referência de figurino, que introduziu um tom de pele diferente por causa da luz refletida.
Fluxo de trabalho completo: da ficha do personagem ao clipe final
O fluxo abaixo funciona tanto para conteúdo narrativo quanto para anúncios, tutoriais e séries episódicas. A ordem importa: cada etapa reduz o espaço de variação da seguinte.
Etapa 1 — Construir a bíblia visual do personagem
Antes de gerar qualquer vídeo, monte um documento com oito a doze imagens aprovadas do personagem. Inclua variações de ângulo, expressão e enquadramento, além de uma descrição textual fixa de quatro a seis linhas: idade aproximada, formato do rosto, cor e corte de cabelo, tom de pele, traços marcantes, vestuário padrão e paleta. Essa descrição será reaproveitada em todos os prompts, sem sinônimos criativos.
A bíblia visual resolve dois problemas ao mesmo tempo: cria uma fonte única de verdade para toda a equipe e reduz a tentação de "melhorar" o personagem no meio do projeto, o que reinicia o trabalho de consistência.
Etapa 2 — Gerar e aprovar um keyframe mestre
O keyframe mestre é a imagem que define a aparência canônica. Gere várias opções, escolha uma e trate-a como bloqueada. A partir dela, todo plano derivado deve ser comparado lado a lado. Um truque útil é montar uma folha de contato com o keyframe no centro e as variações em volta: desvios de identidade ficam evidentes quando as imagens estão próximas.
Ao aprovar o keyframe, verifique proporções faciais, posição dos olhos, linha do cabelo e formato das mãos. Mãos e orelhas são os pontos onde a degradação começa e se propaga para as cenas seguintes.
Etapa 3 — Ancorar o keyframe em image-to-video
A maioria dos pipelines consistentes não parte de texto puro. Eles partem de imagem para vídeo: o keyframe aprovado é a primeira referência, e o prompt descreve movimento, câmera e ação, não aparência. Essa separação é a regra mais importante deste guia. Se o prompt de vídeo tentar redescrever o rosto, ele compete com a imagem e a identidade derrapa.
Movimentos pequenos e lentos preservam identidade. Movimentos amplos de cabeça, giros completos e mudanças bruscas de iluminação são os testes mais duros. Se o plano exige um giro de 180 graus, divida em dois planos com keyframes intermediários em vez de forçar um único clipe.
Etapa 4 — Trocar cenário sem trocar identidade
Aqui entra a fusão multi-imagem. Mantenha a referência facial fixa e substitua apenas a referência de ambiente. Ao mudar de um escritório para uma rua à noite, a temperatura de cor precisa ser ajustada na referência de cenário, não no prompt do personagem. Se a pele ficar fria demais, corrija a luz do ambiente em vez de mexer na referência de rosto.
Uma técnica eficaz é gerar um novo keyframe estático do personagem no novo cenário, aprová-lo e só então animar. Isso custa menos tempo do que tentar corrigir identidade dentro de um clipe já renderizado.
Etapa 5 — Montagem, continuidade e pós-produção
Na edição, ordene os planos e assista sem áudio. A continuidade de identidade é percebida na sequência, não no plano isolado. Se um plano destoa, corte ou regenere apenas ele. Ferramentas de correção de cor e estabilização ajudam a unificar a série, mas não consertam troca de rosto.
Vale reservar uma etapa final para padronização: mesma curva de contraste, mesma saturação, mesmo grão. Uniformizar a imagem faz a consistência de personagem parecer ainda mais sólida do que é.
Como escrever prompts que preservam identidade
Prompt de vídeo consistente é prompt de movimento. Quanto menos ele fala sobre aparência, melhor. O objetivo é descrever ação, ritmo, direção de câmera e atmosfera, deixando forma e cor para as referências visuais.
Estrutura de prompt em camadas
Uma estrutura confiável tem quatro blocos: sujeito e ação, câmera, iluminação e atmosfera, e restrições. Exemplo: "a pessoa caminha lentamente em direção à janela, câmera em travelling lateral suave, luz difusa da manhã, tons neutros, sem cortes rápidos, sem mudança de figurino". O bloco de restrições é frequentemente ignorado e é justamente o que evita deriva.
Mantenha os mesmos termos descritivos em todos os planos de uma sequência. Se um plano diz "luz difusa da manhã", o próximo não deve dizer "luz suave de amanhecer" apenas por variedade estilística. Consistência lexical produz consistência visual.
O que evitar no prompt
Evite listas longas de adjetivos faciais, nacionalidades, idades exatas e comparações com celebridades. Evite também instruções conflitantes como "close-up" e "corpo inteiro" no mesmo prompt. E nunca descreva duas fontes de luz com direções opostas, a menos que queira um resultado imprevisível.
Outro erro comum é pedir mudança de figurino por texto. Se o personagem precisa de duas roupas, crie dois keyframes. O texto raramente controla tecido com precisão suficiente para manter coerência entre planos.
Escolha de modelos e ferramentas: critérios práticos
Não existe um modelo que resolva tudo. O melhor pipeline combina ferramentas especializadas, e a escolha deve partir do tipo de plano, não da popularidade da ferramenta.
Vídeo com controle de keyframe
Para narrativas com personagem recorrente, priorize modelos que aceitam imagem inicial e, idealmente, imagem final. Esse controle duplo é o que permite encadear planos sem salto. Modelos populares de geração de vídeo costumam oferecer variações de qualidade e duração; teste o mesmo keyframe em mais de um e compare a estabilidade facial quadro a quadro antes de decidir.
Ferramentas de imagem e retoque
A etapa estática merece um modelo de imagem forte em fidelidade a referência. Ferramentas com controle por máscara, inpainting e composição manual permitem corrigir mãos, cabelo e detalhes pequenos sem regenerar tudo. Um editor com camadas ainda é o lugar mais rápido para consertar uma orelha torta.
Áudio, voz e ritmo
Consistência não é só visual. Uma voz que muda de timbre entre episódios quebra a sensação de continuidade tanto quanto um rosto diferente. Escolha uma voz de referência, mantenha os mesmos parâmetros e documente a configuração. Para conteúdo narrado, alinhar o ritmo da fala aos cortes reduz a necessidade de correções visuais.
Erros comuns que quebram a consistência
O primeiro erro é usar referências de baixa resolução. O modelo completa as lacunas com invenção, e a invenção varia. O segundo é mudar o prompt entre planos "para dar variedade": variedade de identidade é exatamente o que não se quer.
O terceiro erro é ignorar proporção de tela e distância focal. Um rosto gerado em plano fechado e reaproveitado em plano aberto tende a distorcer a silhueta, porque o modelo nunca viu o corpo inteiro. O quarto é corrigir problemas no vídeo quando a solução está na imagem estática.
Um quinto erro, menos óbvio, é escalar cedo demais. Produzir trinta cenas antes de validar a identidade em três planos diferentes multiplica retrabalho. Valide primeiro, produza depois.
Cenários de uso onde isso compensa
Conteúdo educativo e explicativo se beneficia enormemente de um apresentador digital consistente: grava-se uma vez a identidade visual e produzem-se dezenas de episódios. Séries narrativas curtas, campanhas com múltiplas variações de anúncio e conteúdos localizados em vários idiomas também ganham muito, porque o mesmo personagem pode ser reaproveitado com textos diferentes.
Já projetos que exigem atuação dramática sutil, contato físico complexo ou interação detalhada entre várias pessoas ainda demandam planejamento cuidadoso e, muitas vezes, combinação com captura real. Reconhecer esse limite evita frustração e economiza tempo.
Checklist antes de publicar
Antes de exportar, confira: o keyframe mestre continua sendo a referência de comparação; nenhum plano introduz figurino ou penteado novo por acidente; a temperatura de cor está uniforme entre cenas; as mãos e o cabelo resistem ao quadro a quadro; a voz mantém o mesmo timbre; e a sequência assistida sem áudio ainda parece a mesma pessoa.
Se algum item falhar, corrija antes de adicionar trilha e efeitos. É muito mais barato ajustar um plano do que remediar uma série inteira.
Perguntas frequentes
Quantas imagens de referência preciso para começar? Quatro a seis bem escolhidas costumam ser suficientes para um personagem principal. Qualidade e variedade de ângulo importam mais que quantidade.
Posso manter o mesmo personagem em estilos visuais diferentes? Sim, mas trate como projetos separados. Cada estilo exige seu próprio keyframe aprovado, porque a tradução do rosto para outra linguagem visual altera proporções.
Como corrigir um plano que saiu levemente diferente? Regenere a partir do mesmo keyframe com um prompt mais curto e mais focado em movimento. Se o desvio persistir, gere um keyframe intermediário para aquele momento específico.
Vale a pena usar vídeo em vez de imagem estática? Para retenção de audiência, sim. Movimento sutil aumenta o tempo de atenção mesmo quando a cena é simples.
Quanto tempo leva para montar esse fluxo? A primeira bíblia visual e o keyframe mestre concentram a maior parte do esforço. Depois disso, cada novo plano se torna progressivamente mais rápido, porque as decisões já estão tomadas e documentadas.
O ganho real de dominar fusão de imagens e consistência de personagens não está em fazer mais vídeos, mas em fazer vídeos que possam pertencer ao mesmo universo. Quando identidade, luz e voz permanecem estáveis, a atenção do espectador migra do defeito técnico para a história — que é exatamente onde ela deveria estar desde o início.
