
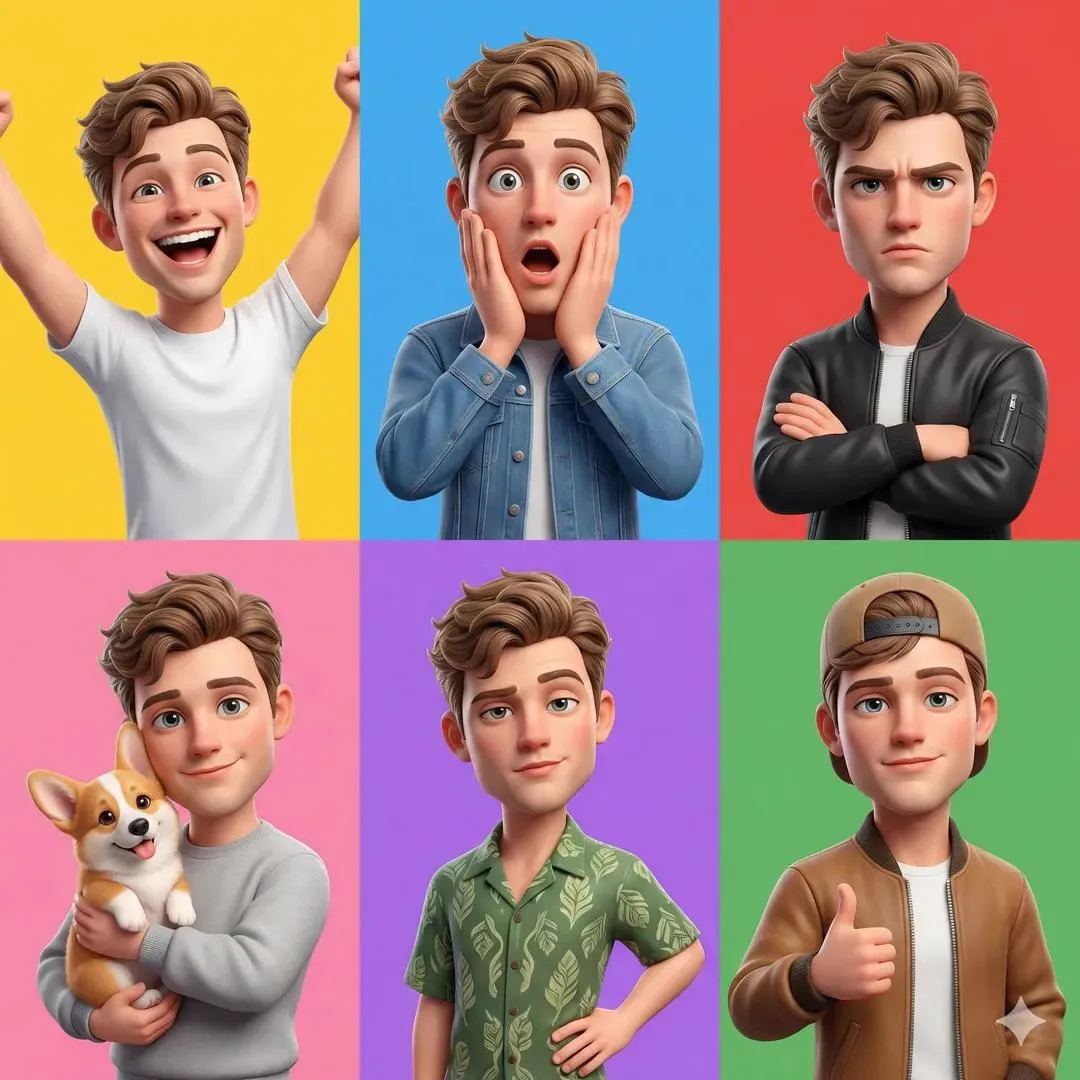
Pierwsze próby z generowaniem wideo uczą każdy zespół tej samej lekcji: jedno piękne ujęcie jest łatwe, ale dziesięć ujęć z tym samym bohaterem to zupełnie inna liga. Twarz dryfuje, kurtka zmienia odcień, blizna znika, a wiek postaci skacze o dekadę między scenami. Fuzja wielu obrazów (multi-image fusion) powstała dokładnie po to, aby rozwiązać ten problem systemowo, a nie łatać go przy każdym kadrze. Poniżej znajdziesz praktyczne omówienie technologii, kompletny workflow produkcyjny oraz kryteria, które decydują o tym, czy Twój bohater przetrwa cały film.
Dlaczego spójność bohatera to najtrudniejszy problem w wideo AI
Model generujący wideo nie ma pamięci narracyjnej. Rozumie ruch w oknie kilku sekund, ale klatka czterechsetna nie „wie”, jak wyglądała klatka dwunasta, dopóki nie dostanie zewnętrznego przypomnienia. Każda scena staje się więc osobną generacją, a tożsamość jest rekonstruowana od zera — z innym ziarnem szumu, inną interpretacją promptu i innym światłem.
Efekt ten nazywamy dryfem tożsamości. Objawia się stopniowo: najpierw zmienia się kształt brwi, potem proporcje nosa, na końcu cała twarz. Widz nie potrafi wskazać momentu, w którym coś się zepsuło, ale czuje, że „to już nie ten sam człowiek”. W narracji jest to zabójcze, bo empatia opiera się na rozpoznawalności.
Druga warstwa problemu jest czysto produkcyjna. Garderoba, rekwizyty, tatuaże, kolor włosów i biżuteria to elementy, które muszą być identyczne w każdej scenie. W reklamie zmiana odcienia opakowania trzymanego w dłoni to błąd, który kosztuje. W serialu animowanym niespójny strój to widoczna wada jakości. W materiałach szkoleniowych zmieniająca się twarz prowadzącego podkopuje zaufanie do całego kursu.
Trzecia warstwa to narzędzia. Wiele rozwiązań oferuje zamianę twarzy w postprodukcji jako szybką naprawę. To jednak łatka, nie rozwiązanie: przy szybkim ruchu głowy krawędzie się rozjeżdżają, oświetlenie twarzy nie zgadza się z resztą kadru, a mimika traci naturalność. Znacznie stabilniej jest zadbać o tożsamość już na etapie generowania, a nie po nim.
Dlatego warto myśleć o spójności jak o warstwie infrastruktury. Nie jest to pojedyncza funkcja, którą się włącza, lecz zestaw decyzji: jak przygotowujesz referencje, jak kontrolujesz warunkowanie i jak weryfikujesz ciągłość między ujęciami.
Czym jest fuzja wielu obrazów i jak działa w praktyce
Fuzja wielu obrazów to rodzina technik, w których model nie otrzymuje jednego zdjęcia referencyjnego, lecz zestaw kilku do kilkunastu, a następnie buduje z nich zwartą reprezentację tożsamości. Ta reprezentacja jest wstrzykiwana do procesu generowania przy każdej klatce, niezależnie od pozy, kąta kamery i oświetlenia.
Kluczowa różnica względem prostego warunkowania pojedynczym obrazem polega na rozdzieleniu cech stałych od zmiennych. Jedno zdjęcie niesie ze sobą przypadkowości: cień na policzku, konkretny obrót głowy, temperaturę światła z okna. Model chętnie je kopiuje, bo są najsilniejszym sygnałem w danych wejściowych. Zestaw zdjęć pozwala mu wywnioskować, co jest istotą postaci — kształt twarzy, proporcje, kolor oczu — a co jedynie okolicznością danego kadru.
Etap pierwszy: analiza wejścia i ekstrakcja cech
Pipeline zaczyna się od analizy. Na każdym zdjęciu wykrywana jest twarz, wyznaczane są punkty charakterystyczne, a następnie obliczany jest wektor tożsamości z sieci rozpoznawania twarzy. Równolegle działa segmentacja: włosy, skóra, ubranie, dodatki. Z tego powstaje paleta kolorów, estymacja głębi i mapa proporcji ciała.
Na tym etapie jakość danych wejściowych przekłada się wprost na jakość wyniku. Rozmyte, mocno skompresowane lub przefiltrowane zdjęcia dają wektor tożsamości pełen szumu. Model nie odróżni wtedy rzeczywistej cechy postaci od artefaktu kompresji i będzie próbował odtworzyć oba.
Etap drugi: mechanizmy fuzji
Łączenie referencji odbywa się zwykle przez mechanizmy uwagi. Model dla każdej cechy decyduje, z którego zdjęcia czerpać informację, i nadaje im różne wagi. Dobrze zaprojektowany system unika tak zwanego uśredniania, które brzmi rozsądnie, ale w praktyce rozmywa twarz do nijakiego przeciętniaka. Zamiast liczyć średnią arytmetyczną embeddingów, wybiera reprezentacje najbardziej zgodne między sobą i odrzuca odstające.
Drugim elementem jest kotwiczenie klatkami kluczowymi. Zamiast referencji działać globalnie, wybrane ujęcia stają się punktami odniesienia dla konkretnych segmentów sceny. Dzięki temu tożsamość nie jest negocjowana od nowa w każdej sekundzie.
Etap trzeci: spójność na poziomie modelu generatywnego
Warunkowanie tożsamością wstrzykuje się na kilku poziomach sieci jednocześnie — od wczesnych warstw, które odpowiadają za ogólną strukturę, po późne, które decydują o detalach twarzy. W modelach wideo dochodzi warstwa uwagi temporalnej, propagująca informację między klatkami w obrębie klipu.
W praktyce oznacza to, że spójność trzeba zaplanować na trzech poziomach naraz: w obrębie jednego ujęcia, między ujęciami w tej samej scenie oraz między scenami. Każdy z tych poziomów ma inne źródło błędów i inne narzędzia kontroli.
Przygotowanie zestawu referencji: praktyka
Większość problemów ze spójnością, z którymi spotykają się zespoły, nie wynika z modelu, ale z referencji. To najtańszy i najbardziej zaniedbany etap produkcji.
Ile zdjęć naprawdę potrzebujesz
Trzy do pięciu zdjęć to absolutne minimum dla prostej postaci w krótkim materiale. Osiem do dwunastu daje realną kontrolę nad mimiką, kątami i garderobą. Jeśli planujesz trenować własny adapter tożsamości, przygotuj piętnaście do trzydziestu starannie wyselekcjonowanych zdjęć.
Więcej nie zawsze znaczy lepiej. Dwadzieścia zdjęć z tego samego kąta i tego samego oświetlenia wnosi mniej informacji niż sześć zdjęć różnorodnych. Liczy się pokrycie przestrzeni wariantów, a nie liczba plików.
Jakie ujęcia wybrać
Podstawowy zestaw powinien zawierać: ujęcie frontalne neutralne, frontalne z uśmiechem, trzy czwarte z lewej i z prawej, profil oraz co najmniej jedno ujęcie półciała dla proporcji i garderoby. Dodaj jedno ujęcie w ruchu, jeśli postać ma być dynamiczna.
Oświetlenie powinno być miękkie i równomierne, ale nie identyczne na wszystkich zdjęciach — model musi nauczyć się, że kształt twarzy nie zależy od kierunku światła. Tła najlepiej różne i spokojne, żeby segmentacja nie myliła postaci z otoczeniem.
Czego unikać
Filtry upiększające i wygładzanie skóry usuwają dokładnie te mikrodetale, po których widz rozpoznaje twarz. Mocny makijaż sceniczny, okulary, nakrycia głowy i szaliki zasłaniające linię żuchwy wprowadzają sprzeczne sygnały. Ostre cienie dzielą twarz na pół. Zdjęcia grupowe powodują przeciekanie cech innych osób. Silna kompresja i obróbka HDR zniekształcają kolory.
Osobna kategoria to zdjęcia sprzeczne wewnętrznie: inne włosy na dwóch zdjęciach, inny kolor oczu wynikający z korekty, tatuaż obecny tylko na jednym. Model nie zapyta, które są prawdziwe — po prostu zgubi się w środku.
Workflow produkcyjny: od pomysłu do gotowej sceny
Poniższy proces sprawdza się zarówno przy krótkiej reklamie, jak i przy dłuższym materiale epizodycznym.
- Biblia postaci. Zanim wygenerujesz cokolwiek, opisz bohatera: wiek, sylwetka, rysy, włosy, ubiór, akcesoria, sposób poruszania się. Zapisz cechy, które są nienaruszalne, oraz te, które mogą się zmieniać w zależności od sceny.
- Sesja referencyjna. Zbierz lub wygeneruj zdjęcia według zasad z poprzedniej sekcji. Ujednolić rozdzielczość i kadrowanie.
- Selekcja i czyszczenie. Odrzuć wszystko rozmyte, przemakowane i sprzeczne. Usuń tła, jeśli narzędzie tego wymaga, i sprawdź, czy kolory skóry nie zostały przekłamane.
- Test kalibracyjny. Wygeneruj trzy krótkie ujęcia: zbliżenie, plan średni i ujęcie w ruchu. Oceniaj nie urodę kadru, ale stabilność tożsamości. Ten test kosztuje kilka minut, a oszczędza godziny.
- Ustalenie parametrów. Zapisz seed, wersję modelu, wagi referencji i ustawienia kamery. Bez zapisanego seeda powtarzalność jest iluzją.
- Klatki kluczowe. Generuj najpierw pojedyncze, dopracowane kadry dla najważniejszych momentów sceny. To one będą kotwicami dla ruchu.
- Propagacja do klipów. Zatwierdzone klatki zamień w krótkie klipy, trzymając ten sam zestaw referencji. Generuj raczej wiele krótkich fragmentów niż jeden długi — łatwiej wtedy wymienić wadliwy element bez psucia całości.
- Kontrola ciągłości. Złóż materiał w montażu i obejrzyj go bez dźwięku, wyłącznie pod kątem tożsamości, garderoby i rekwizytów.
- Postprodukcja. Korekcja kolorów, ujednolicenie ziarna, stabilizacja, udźwiękowienie. Grading wykonuj na końcu, żeby nie maskował problemów, które trzeba naprawić u źródła.
Kryteria wyboru narzędzia
Rynek narzędzi do generowania wideo zmienia się szybciej niż jakiekolwiek recenzje, więc zamiast listy produktów lepiej mieć własną listę kryteriów.
- Typ i liczba referencji. Czy narzędzie przyjmuje kilka zdjęć jednocześnie, czy tylko jedno? Czy pozwala rozdzielić referencję postaci od referencji stylu?
- Kontrola pozy i kamery. Możliwość sterowania ruchem przez szkic, mapę głębi lub nagranie referencyjne jest ogromną oszczędnością przy powtarzalnych ujęciach.
- Długość i stabilność klipu. Krótkie klipy są stabilniejsze. Jeśli narzędzie oferuje długie sekwencje, sprawdź, czy nie robi tego kosztem dryfu tożsamości.
- Powtarzalność. Czy ten sam seed i ten sam prompt dają ten sam wynik po tygodniu? To warunek pracy zespołowej.
- Rozdzielczość i format wyjściowy. Osobne kanały, przezroczystość, wysoka rozdzielczość i dobre wsparcie dla montażu oszczędzają etap konwersji.
- Praca lokalna lub w chmurze. Lokalnie: pełna kontrola i prywatność, ale wymagany sprzęt. W chmurze: wygoda i skalowanie, ale zależność od limitów i dostępności.
- Możliwość dostrajania. Adaptery tożsamości, trenowanie na własnych danych i wtyczki do typowego środowiska graficznego dają największą kontrolę.
- Prawa i zgodność. Sprawdź zasady dotyczące wizerunku osób rzeczywistych, licencje modeli i kwestie komercyjnego wykorzystania przed rozpoczęciem produkcji.
- Automatyzacja. Dostęp do API i możliwość skryptowania wsadowego generowania przydają się, gdy potrzebujesz setek ujęć.
Spójność w długich formach: serial, reklama, kurs
W materiałach krótkich wystarczy dyscyplina. W długich formach potrzebny jest system.
Pierwszym elementem jest segmentacja. Podziel scenariusz na bloki, w których bohater ma podobny wygląd: tę samą garderobę, fryzurę, porę dnia. Zmiana stroju to naturalna granica, za którą można odświeżyć referencje bez szkody dla wrażenia ciągłości.
Drugim elementem jest rejestr produkcji: tabela z numerem sceny, użytymi referencjami, seedem, wersją modelu i datą. Brzmi technokratycznie, ale gdy po dwóch tygodniach trzeba dograć jedno ujęcie, ten rejestr ratuje projekt.
Trzecim jest biblioteka bohatera. Trzymaj osobny folder z zatwierdzonymi zdjęciami referencyjnymi oraz z najlepszymi wygenerowanymi kadrami, które mogą służyć jako dodatkowe kotwice. Z czasem sam materiał staje się najlepszym źródłem spójności.
Szczególną uwagę zwróć na sceny z dwiema postaciami. Modele mają tendencję do mieszania cech, zwłaszcza gdy bohaterowie są podobni wiekiem i sylwetką. Ratunkiem jest różnicowanie palety kolorów ubrań, mocne rozróżnienie sylwetek oraz generowanie postaci osobno i łączenie ich w kompozycji dopiero na etapie montażu, jeśli narzędzie na to pozwala.
Kontrola stylu i atmosfery bez utraty tożsamości
Styl i tożsamość to dwa różne rodzaje warunkowania i mieszanie ich w jednym zdaniu promptu to najczęstsza przyczyna problemów. Zdanie opisujące bohatera powinno zawierać wyłącznie cechy bohatera. Zdanie opisujące styl powinno zawierać wyłącznie język obrazu: typ obiektywu, ziarno, kontrast, paletę, kierunek światła.
Jeżeli narzędzie pozwala na osobne referencje stylu, używaj ich konsekwentnie w całym projekcie. Jeśli nie, ustal styl opisowo i nie zmieniaj go między scenami — to najprostszy sposób na wizualną jedność.
Największa pułapka polega na tym, że silna referencja stylu potrafi zjeść tożsamość. Gdy stylizacja jest bardzo wyrazista, model zaczyna upraszczać twarz, dopasowując ją do konwencji: manga, akwarela, film noir. Wtedy trzeba albo osłabić wagę stylu, albo zaakceptować umowną reprezentację bohatera i pilnować jedynie jego stałych znaków rozpoznawczych: koloru włosów, kształtu sylwetki, charakterystycznego elementu garderoby.
Ostatnią warstwą jest grading. Robiony konsekwentnie na całym materiale potrafi ukryć drobne różnice w barwie skóry i oświetlenia, które w surowym materiale rzucają się w oczy. Nigdy jednak nie zastąpi spójności tożsamości — to narzędzie wykończeniowe, nie naprawcze.
Typowe błędy i sposoby ich naprawy
Za mało różnorodnych referencji. Objawia się tym, że bohater wygląda dobrze tylko w jednej pozie. Rozwiązanie: dodaj ujęcia z różnych kątów i przy różnym świetle.
Referencje sprzeczne. Bohater ma na przemian dwoje różnych oczu albo inną linię włosów. Rozwiązanie: usuń zdjęcia odstające, nawet jeśli są najładniejsze.
Zbyt duża waga referencji. Twarz wygląda jak naklejona, traci mimikę i reagowanie na światło. Rozwiązanie: obniż wagę warunkowania i pozwól modelowi interpretować cechy.
Zbyt mała waga referencji. Bohater zmienia się co ujęcie. Rozwiązanie: zwiększ wagę i dodaj kotwicę w postaci zatwierdzonej klatki kluczowej.
Zamiana twarzy jako główna metoda. Efekt jest nienaturalny przy ruchu i przy skrętach głowy. Rozwiązanie: traktuj zamianę twarzy wyłącznie jako drobną korektę, nie jako fundament.
Brak zapisanego seeda. Nie da się odtworzyć udanego ujęcia. Rozwiązanie: zapisuj parametry przy każdym zatwierdzonym kadrze.
Generowanie długich klipów na raz. Dryf narasta z czasem trwania. Rozwiązanie: krótkie segmenty i montaż.
Mieszanie dwóch bohaterów w jednym ujęciu bez zabezpieczeń. Cechy przeciekają. Rozwiązanie: rozdzielne generowanie, wyraźne różnice wizualne, ewentualnie kompozycja w postprodukcji.
Checklist przed renderem
Zanim uruchomisz generowanie całej sceny, przejdź tę listę.
- Biblia postaci jest zapisana i zawiera cechy nienaruszalne.
- Zestaw referencji ma co najmniej sześć różnorodnych ujęć.
- Żadne zdjęcie referencyjne nie jest rozmyte, przepalone ani sprzeczne z resztą.
- Wykonany został test kalibracyjny w trzech typach ujęć.
- Parametry, w tym seed i wagi referencji, są zapisane.
- Opis postaci i opis stylu są rozdzielone.
- Klatki kluczowe dla najważniejszych momentów są zatwierdzone.
- Garderoba i rekwizyty mają ustalony, niezmienny wygląd.
- Zadbano o różnicowanie bohaterów w scenach zbiorowych.
- Zaplanowano kontrolę ciągłości po montażu.
- Ustalono zasady dotyczące praw do wizerunku i licencji.
- Przygotowany jest plan naprawczy: które ujęcia najłatwiej wygenerować ponownie.
FAQ
Ile zdjęć referencyjnych wystarczy na start? Na prosty, krótki materiał wystarczy trzy do pięciu. Do pracy nad dłuższą formą przygotuj osiem do dwunastu różnorodnych ujęć, a przy trenowaniu własnego adaptera piętnaście do trzydziestu.
Czy zamiana twarzy może zastąpić fuzję wielu obrazów? Nie w produkcji, w której liczy się naturalność ruchu. Zamiana twarzy sprawdza się jako drobna korekta pojedynczych kadrów, ale przy dynamicznych scenach zdradza się nienaturalnymi krawędziami i niedopasowanym światłem.
Dlaczego bohater zmienia się najbardziej w scenach akcji? Bo szybki ruch, rozmycie i skrajne kąty utrudniają modelowi odtworzenie cech. Pomaga skrócenie klipów, dodanie referencji w ruchu oraz większa liczba zatwierdzonych klatek kluczowych.
Czy spójność da się utrzymać między projektami? Tak, jeśli prowadzisz rejestr parametrów i bibliotekę referencji. Najlepiej działa to wtedy, gdy oprócz zdjęć bazowych przechowujesz także najlepsze wygenerowane kadry, które stają się dodatkowymi kotwicami.
Jak pogodzić wyrazisty styl z wiernością twarzy? Rozdziel warunkowanie stylu od warunkowania postaci, a jeśli styl zaczyna upraszczać rysy, osłab jego wagę i dopracuj wygląd w korekcji kolorów. Pamiętaj, że przy bardzo konwencjonalnej stylizacji wierność fotograficzna nie jest celem — ważniejsza jest stałość znaków rozpoznawczych.
Od czego zacząć, jeśli dopiero wchodzę w temat? Od bibili postaci i porządnego zestawu referencji. To dwie godziny pracy, które wyprzedzają tygodnie poprawiania dryfu, niezależnie od tego, jakiego narzędzia do generowania wideo używasz.
