
Perché il testo-video fotorealistico è un flusso di lavoro, non un tasto magico
Per anni la promessa è stata semplice: scrivi una frase e ottieni un film. Dopo diverse generazioni di modelli generativi, la realtà operativa è un'altra. Il risultato non dipende quasi mai dallo strumento scelto, ma dall'architettura del processo che costruisci attorno ad esso: sceneggiatura, riferimenti visivi, controllo della coerenza, suono e post-produzione. Chi tratta la generazione video come un pulsante magico ottiene clip spettacolari da cinque secondi, difficili da montare in una sequenza continua. Chi la tratta come una pipeline ottiene novanta secondi di racconto credibile, con personaggi riconoscibili e luce coerente da un'inquadratura all'altra.
Il contesto italiano aggiunge variabili specifiche che vale la pena conoscere prima di iniziare. La luce mediterranea, con ombre nette e temperature calde, è molto diversa dalla luce diffusa del Nord Europa su cui molti modelli sono stati addestrati: se non la descrivi con precisione, ottieni una patina grigia che non assomiglia a nessuna strada italiana. Le architetture storiche, con proporzioni e materiali particolari, mettono in crisi i modelli geometrici. Gli interni domestici italiani, con pavimenti in cotto, persiane e luce filtrata, sono un caso di studio a sé. E poi c'è la lingua: dialoghi, voice over e testi a schermo devono suonare naturali, non tradotti.
I casi d'uso in cui questo approccio funziona meglio sono piuttosto concreti:
- Turismo e ospitalità: anteprime di destinazioni, camere di hotel, esperienze gastronomiche, con riprese impossibili da organizzare nella realtà.
- Pubblicità locale e retail: varianti di uno stesso spot per città, stagioni o prodotti diversi, senza rigirare nulla.
- Moda e arredo: cataloghi animati a partire da still life e scatti di prodotto.
- Formazione aziendale: scenari simulati, procedure di sicurezza, onboarding, con attori virtuali coerenti.
- Concept e previsioni: presentare un'idea a un cliente prima di spendere in una produzione reale.
In tutti questi casi il valore non sta nella singola clip, ma nella ripetibilità: riuscire a produrre dieci scene coerenti in due giorni invece di due mesi.
Come funziona un motore testo-video: quello che conviene sapere
La maggior parte dei motori moderni combina due famiglie di tecniche. Da un lato i modelli di diffusione, che partono da rumore casuale e lo trasformano progressivamente in immagini coerenti all'interno di uno spazio latente compresso. Dall'altro i modelli transformer con attenzione temporale, che imparano a mantenere la relazione tra fotogrammi consecutivi: è qui che si decide se un volto resta lo stesso per quattro secondi o si deforma a metà clip.
Il vero collo di bottiglia non è la qualità del singolo fotogramma, ma la coerenza temporale. Un'immagine statica può essere perfetta; una sequenza rivela immediatamente ogni incoerenza: un orecchio che cambia forma, una manica che si allunga, un riflesso che si sposta senza motivo. Per questo il fotorealismo in movimento è un problema di dettagli statistici piccolissimi — pori della pelle, fibre dei tessuti, micro-ombre sotto il mento — che devono restare stabili nel tempo.
Una distinzione pratica fondamentale è quella tra text-to-video e image-to-video:
- Text-to-video: il modello decide composizione, volto, abbigliamento e luce. Massima libertà, minima ripetibilità.
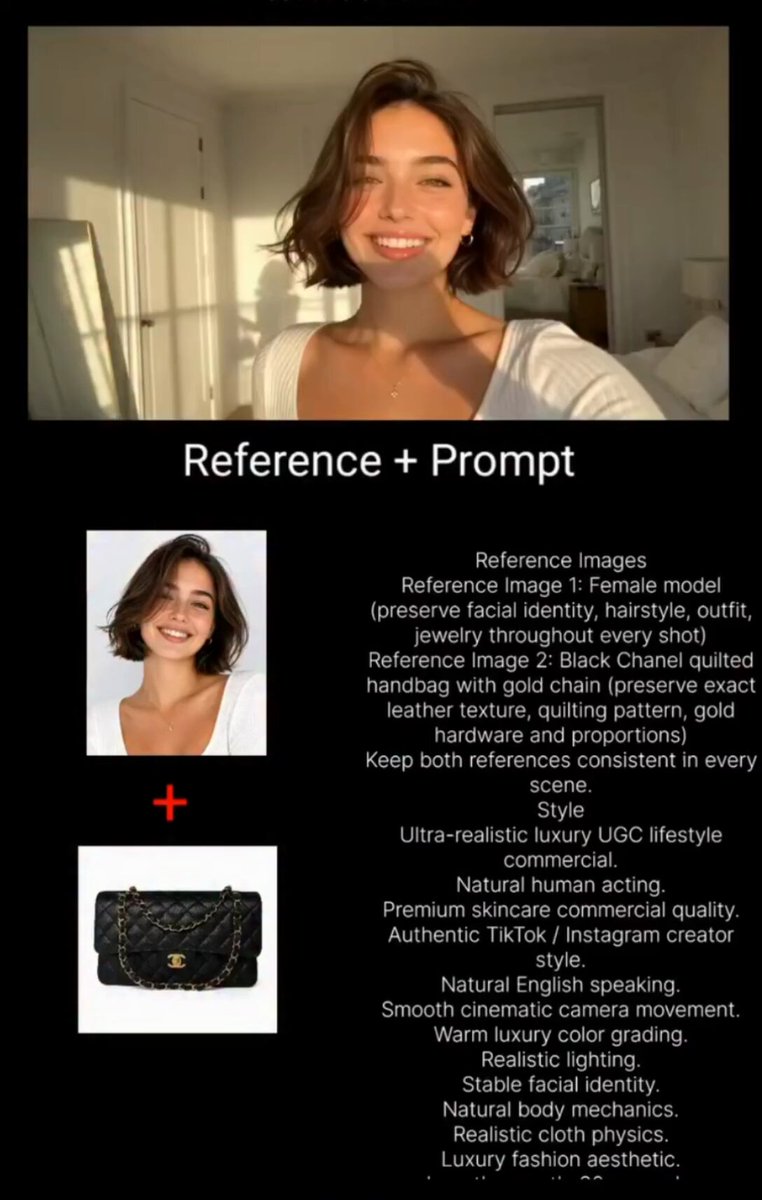
- Image-to-video: fornisci un fotogramma di partenza e il modello lo anima. Molto più controllo, ideale quando hai già definito il look.
Nella pratica professionale si lavora quasi sempre in due fasi: prima si generano fotogrammi chiave statici (molto più facili da correggere), poi si animano. A questo si aggiungono i controlli condizionati — mappe di profondità, pose scheletriche, traiettorie di camera, maschere di movimento — che riducono lo spazio di improvvisazione del modello.
Un'ultima cosa da sapere: la durata ideale di una clip generata è breve, in genere tra tre e sei secondi. Oltre quella soglia il rischio di morphing cresce rapidamente. Il montaggio si costruisce accumulando molte clip corte e ben controllate, non cercando il piano sequenza perfetto.
Preparare il testo: dal copione al prompt strutturato
Il passaggio più sottovalutato è la traduzione della sceneggiatura in istruzioni operative. Un copione pensato per attori umani contiene intenzioni, sottotesti e indicazioni emotive che un modello generativo non sa interpretare. Serve una riscrittura in linguaggio visivo.
La struttura del prompt in sei blocchi
Un prompt efficace si compone di sei elementi, in quest'ordine:
- Soggetto: età, tratti fisici, abbigliamento, dettagli distintivi.
- Azione: un solo movimento principale, descritto in modo meccanico.
- Ambiente: luogo, materiali, elementi di sfondo, meteo.
- Luce: direzione, qualità, temperatura, ora del giorno.
- Camera e ottica: focale, distanza, tipo di movimento, stabilizzazione.
- Resa: tipo di grana, contrasto, formato, riferimenti di stile fotografico.
Un esempio debole: un uomo triste cammina in una città italiana, cinematic, 4k. Il modello non sa cosa significhi "triste" e non conosce nessuna "città italiana" specifica.
Un esempio forte: un uomo di quarant'anni con cappotto di lana grigio cammina lentamente verso la camera su una strada lastricata bagnata, luce radente di fine giornata da sinistra, obiettivo 35mm, camera a mano con leggero ondeggiamento, facciate color ocra sfocate sullo sfondo, grana sottile, contrasto medio.
Scrivere in italiano quando il modello "ragiona" in inglese
Molti motori comprendono bene le istruzioni in italiano, ma i termini tecnici di fotografia e camera restano più affidabili nella loro forma internazionale: dolly in, rack focus, shallow depth of field, golden hour, handheld, low angle. La strategia più solida è ibrida: descrizione narrativa in italiano, vocabolario tecnico in inglese, dialoghi, voice over e testi a schermo interamente in italiano.
Per i dialoghi conviene scrivere frasi brevi, con ritmo naturale e senza subordinate lunghe. Le battute lunghe aumentano il rischio di sincronizzazione labiale imprecisa e di espressioni artificiali.
Errori di scrittura più comuni
- Aggettivi emotivi astratti: "emozionante", "malinconico", "coinvolgente" non producono nulla di visibile. Sostituisci con comportamenti osservabili: "sguardo abbassato", "spalle curve", "mani in tasca".
- Negazioni: "senza persone", "niente auto" vengono spesso ignorate. Descrivi lo stato positivo: "strada deserta", "piazza vuota all'alba".
- Troppi soggetti: due persone che interagiscono in una clip breve sono già un caso complesso. Aggiungine una alla volta.
- Contraddizioni di luce: "controluce soffuso con ombre nette" confonde il modello. Scegli una direzione.
- Prompt enciclopedici: oltre un certo numero di dettagli il modello inizia a scartarne alcuni in modo casuale. Meglio più clip, ciascuna semplice.
Il workflow operativo in sette passaggi
Questa è la sequenza che riduce al minimo le sorprese, indipendentemente dal motore scelto.
1. Sceneggiatura e shot list. Converti il testo in una lista di inquadrature con durata, azione, tipo di piano e nota audio. Una scena da trenta secondi corrisponde tipicamente a cinque-otto clip.
2. Moodboard. Raccogli tra quindici e venti immagini di riferimento: luce, palette, texture, espressioni. Servono a te per scrivere prompt coerenti, e in alcuni strumenti possono essere usate direttamente come condizionamento.
3. Bibbia visiva. Definisci una volta sola il personaggio principale (età, capelli, barba, abbigliamento, accessori), la palette di colori, il tipo di luce ricorrente e il look finale. Questo documento evita che ogni clip diventi un universo a sé.
4. Keyframe statici. Genera un fotogramma di riferimento per ogni inquadratura. Qui puoi iterare in modo economico: correggere un'immagine è molto più rapido che rigenerare un video.
5. Animazione. Passa i keyframe al motore image-to-video, con clip da tre a sei secondi e almeno quattro-sei tentativi per inquadratura. Tieni traccia del seed vincente: spesso è l'unico modo per riprodurre una variante.
6. Selezione e controllo di continuità. Guarda le clip in sequenza, non una per una. Gli errori che contano — colore che vira, altezza del soggetto che cambia, direzione dello sguardo incoerente — emergono solo nel montaggio.
7. Montaggio, suono e finitura. Taglia sul movimento, aggiungi suono prima di rifinire il colore: l'audio cambia radicalmente la percezione del realismo.
Una regola pratica: se una clip richiede più di dieci tentativi, il problema è nel prompt o nella scelta del modello, non nella sfortuna.
Scegliere il modello giusto per ogni tipo di scena
Non esiste un motore migliore in assoluto, esistono motori adatti a compiti diversi. La tabella seguente riassume i criteri con cui valutare le alternative disponibili.
| Tipo di scena | Priorità | Cosa verificare |
|---|---|---|
| Primi piani e volti | Stabilità dell'identità | Dettaglio pelle, micro-espressioni, sincronizzazione labiale |
| Paesaggi e riprese aeree | Movimento ampio e parallasse | Coerenza geometrica, nitidezza sugli elementi lontani |
| Azione e sport | Fisica credibile | Assenza di arti duplicati, motion blur naturale |
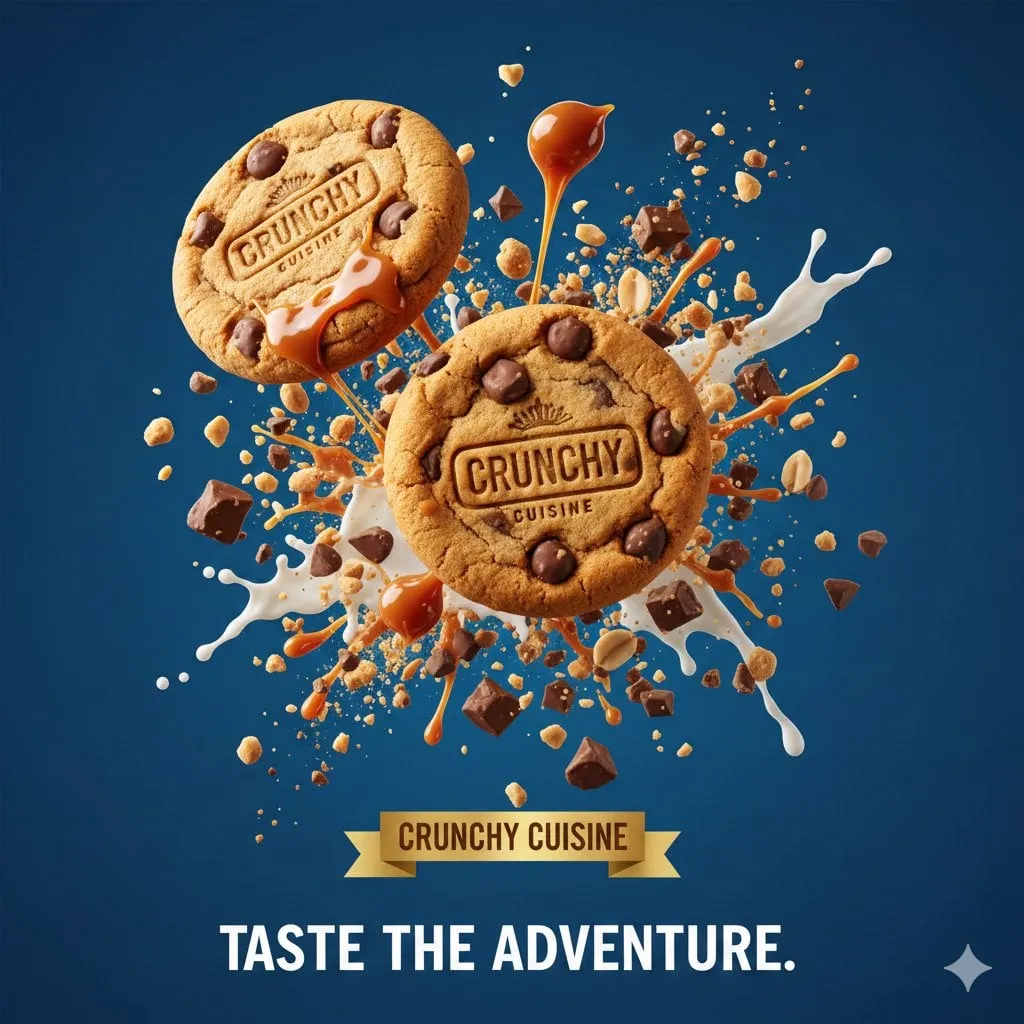
| Prodotto e still life | Precisione dei dettagli | Riflessi, materiali, leggibilità di etichette e marchi |
| Interni e architettura | Prospettiva | Linee rette, luce dalle finestre, proporzioni |
| Stile documentario | Naturalezza | Imperfezioni controllate, camera a mano, grana |
I criteri decisionali da confrontare prima di adottare un motore sono sempre gli stessi:
- Durata massima per clip senza degradazione evidente.
- Risoluzione e formato di output, inclusi i verticali per social.
- Supporto dell'input immagine e di riferimenti di soggetto.
- Controllo della camera: traiettorie, focale, tipo di movimento.
- Coerenza del soggetto su più generazioni consecutive.
- Comprensione dell'italiano nei prompt lunghi e nella sintesi vocale.
- Tempi di generazione e possibilità di lavorare in parallelo.
- Licenza d'uso commerciale dei contenuti prodotti.
Un approccio pragmatico è usare due strumenti in parallelo: uno specializzato nei volti, uno più forte su ambienti e movimento. Il montaggio unisce ciò che nessun singolo motore fa bene da solo.
Illuminazione, camera e recitazione: il vocabolario che cambia il risultato
Luce
La luce è la variabile che incide di più sulla percezione di realismo. Descrivila sempre con direzione e qualità: luce laterale radente, controluce morbido, luce diffusa da finestra a nord, luci pratiche visibili in scena. Aggiungi la temperatura: calda, neutra, fredda. Per l'Italia, indica spesso fine pomeriggio estivo, mezzogiorno con ombre nette, luce filtrata da persiane. Il dettaglio delle ombre nette è ciò che distingue una scena mediterranea da una scena generica.
Camera
Le focali comunicano immediatamente un'intenzione: 24mm per spazi ampi, 35mm per il reportage, 50mm per una visione neutra, 85mm per i ritratti con sfondo sfocato. Il movimento va descritto con precisione: dolly in lento, carrellata laterale, camera a mano con micro-movimenti, steadycam che segue il soggetto. Aggiungi la cadenza: 24fps, motion blur naturale. Sono indicazioni tecniche che riducono drasticamente il numero di tentativi necessari.
Azione e recitazione
I modelli non recitano: eseguono. Un'azione ben scritta contiene un movimento, una direzione e un ritmo. "Si gira verso la finestra e sorride lentamente" funziona molto meglio di "è felice". Per i dialoghi, spezza le battute in clip brevi e alterna i piani: campo e controcampo, primi piani, inserti di mani o oggetti. È il montaggio classico, applicato a materiale generato.
Coerenza visiva: personaggi, oggetti e ambienti tra le scene
La coerenza è il vero discrimine tra un esperimento e un progetto professionale. Il volto che cambia tra due inquadrature distrugge la sospensione dell'incredulità più di qualsiasi difetto tecnico.
Le strategie che funzionano:
- Riferimento visivo fisso: genera un character sheet con tre o quattro angolazioni e usalo come base per tutte le animazioni.
- Tratti distintivi forti: una cicatrice, occhiali dalla montatura riconoscibile, un colore di capelli particolare. Sono ancore che il modello conserva più facilmente.
- Wardrobe coerente: descrivi l'abbigliamento con gli stessi termini in ogni clip.
- Location ricorrenti: riutilizza lo stesso keyframe di sfondo, cambiando solo l'azione in primo piano.
- Color grading unificato: applica la stessa LUT o lo stesso preset a tutte le clip in post-produzione. Nasconde molte piccole differenze.
- Seed coerenti: quando il motore lo consente, mantieni lo stesso seme di base e varia solo la parte di prompt relativa all'azione.
Per gli oggetti vale lo stesso principio: un prodotto, un piatto, un'abitazione devono avere proporzioni e dettagli stabili. In questi casi conviene partire da fotografie reali e animarle, piuttosto che generare da zero.
Post-produzione e suono: dove nasce il realismo finale
Il materiale generato è un grezzo, non un prodotto finito. La finitura è la fase in cui il risultato diventa credibile.
Video:
- Upscaling delle clip a risoluzione di montaggio, con attenzione a non aggiungere dettaglio artificiale sulla pelle.
- Interpolazione dei fotogrammi per fluidità, dosata con cautela: troppa fluidità produce un effetto videogioco.
- Riduzione del flicker: leggero denoise temporale e stabilizzazione aiutano a nascondere micro-variazioni di luminosità.
- Color grading: contrasto, bilanciamento del bianco, curve. Una grana sottile uniforme è il singolo intervento che più aumenta la sensazione di ripresa reale.
- Motion blur: aggiunto in post su movimenti veloci, serve a integrare le clip tra loro.
Audio:
- Voice over in italiano con una voce coerente per tutto il progetto, registrata o sintetizzata ma sempre con lo stesso timbro.
- Room tone: un fondo ambiente continuo sotto ogni scena. La sua assenza è uno dei motivi per cui i video generati "suonano" falsi.
- Sound design: passi, tessuti, porte, traffico lontano. Piccoli suoni sincronizzati con i gesti aumentano enormemente la credibilità.
- Musica: scelta sobria, con dinamica che segue il montaggio.
Un principio controintuitivo ma importante: il realismo perfetto è sospetto. Micro-imperfezioni — un leggero tremolio di camera, un riflesso fuori posto, un movimento non del tutto simmetrico — rendono il risultato più credibile, non meno.
Errori frequenti e come risolverli
Mani e dita deformate. Riduci il movimento, avvicina la camera, o fai uscire le mani dall'inquadratura. In post-produzione, un inserto o un breve taglio risolve senza rigenerare.
Morphing a metà clip. Accorcia la durata, semplifica l'azione, oppure passa a image-to-video partendo da un fotogramma chiave stabile.
Volto che cambia tra le scene. Introduci un riferimento visivo fisso e descrivi sempre gli stessi tratti distintivi con le stesse parole.
Flicker di luminosità. Applica denoise temporale e stabilizzazione, poi uniforma con il color grading.
Movimento a scatti. Verifica la cadenza di generazione e l'interpolazione; a volte basta esportare a una frequenza coerente con quella di montaggio.
Colori che virano da una clip all'altra. Blocca la temperatura di colore nel prompt e correggi in post con una LUT condivisa.
Testo e loghi illeggibili. Non chiedere al modello di scrivere: genera lo sfondo e sovrapponi il testo in post-produzione. È più veloce, preciso e modificabile.
Prompt ignorato. Riduci il numero di elementi, elimina le negazioni, metti l'azione principale all'inizio della descrizione.
Effetto plastica. Aggiungi riferimenti a grana, contrasto medio, luce naturale non perfetta. Riduci le richieste di nitidezza estrema, che enfatizzano l'artificialità.
Tempi di attesa insostenibili. Genera in parallelo, lavora a risoluzione ridotta per la selezione e riserva l'alta qualità solo alle clip approvate.
Criteri decisionali e FAQ
Prima di impegnarti in un progetto, valuta con onestà quando la generazione conviene e quando no.
Conviene per: concept e presentazioni, contenuti verticali ad alta frequenza, scene impossibili o costose da girare, varianti multiple di uno stesso messaggio, animazione di fotografie di prodotto, formazione interna.
Non conviene per: interviste a persone reali, prodotti con dettagli tecnici verificabili, volti noti, contenuti legati a testimonianze autentiche, situazioni in cui la ripresa reale è semplice ed economica.
Domande frequenti
Quanto testo serve per generare una clip? Una descrizione efficace sta tra le trenta e le ottanta parole. Oltre, i dettagli iniziano a competere tra loro.
Meglio text-to-video o image-to-video? Image-to-video per tutto ciò che richiede coerenza: volti, prodotti, location ricorrenti. Text-to-video per esplorare idee e trovare il look.
Quante clip servono per un video da un minuto? Tra quindici e venticinque, con durate medie di tre o quattro secondi e qualche inquadratura più lunga nei momenti calmi.
Serve una GPU? Non necessariamente: molti servizi cloud bastano per progetti piccoli e medi. L'hardware locale diventa rilevante per volumi alti o per esigenze di riservatezza.
I dialoghi in italiano sono affidabili? Le frasi brevi funzionano bene; per battute lunghe conviene generare il video senza audio, poi aggiungere voice over e sincronizzazione in post-produzione.
Come si mantiene lo stesso personaggio in dieci scene? Con un riferimento visivo fisso, descrizioni ripetute con le stesse parole, abbigliamento costante e un color grading unico.
Quanto tempo richiede una scena da trenta secondi? Con un workflow consolidato, tra le quattro e le otto ore, inclusi tentativi, selezione, suono e finitura. Le prime volte il tempo è due o tre volte superiore: la curva di apprendimento sta tutta nella scrittura dei prompt.
Qual è l'errore che costa più tempo? Generare video prima di aver definito i keyframe statici. Correggere un'immagine richiede secondi, rigenerare un video minuti.
