
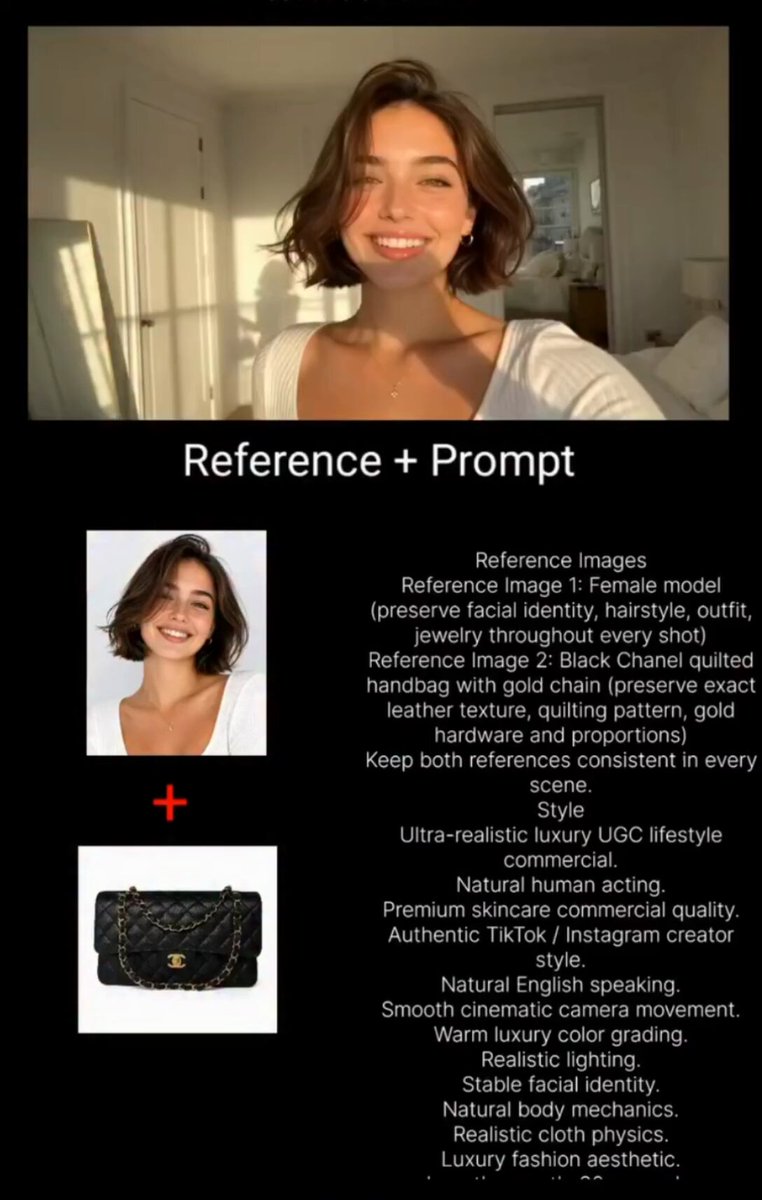
El reto de la consistencia en vídeo generado por IA
El ecosistema de la creación de contenido asistida por inteligencia artificial no deja de crecer. Cada pocos meses aparecen nuevos modelos con capacidades impresionantes para generar imágenes fotorrealistas y secuencias de vídeo sorprendentes. Pero a medida que el número de herramientas se multiplica, también lo hace un problema clásico: la inconsistencia visual entre tomas de una misma pieza.
Cualquiera que haya trabajado con generación por IA conoce la frustración. Se obtiene un plano espectacular, se genera el siguiente con una prompt parecida y, al juntarlos, el personaje tiene otra cara, la iluminación no coincide o el estilo general se desvanece por completo. Es la temida deriva estilística, un obstáculo que puede consumir horas de postproducción y arruinar la inmersión narrativa.
Afortunadamente, existe una respuesta: la fusión de imágenes multi-IA. Esta técnica permite combinar las fortalezas de varios modelos de generación manteniendo una identidad visual unificada a lo largo de toda la narrativa. En este artículo exploramos sus fundamentos técnicos, las técnicas avanzadas para implementarla y cómo integrarla en un flujo de trabajo profesional.
Por qué la fusión multi-IA es imprescindible en 2025
La producción seria de largometrajes, anuncios publicitarios o series web exige que un personaje digital se mantenga reconocible en todo momento. Si el protagonista cambia de rostro entre escenas, la historia pierde credibilidad. La fusión multi-IA resuelve esto permitiendo que varios motores de generación compartan un mismo marco de referencia. Las estimaciones de la industria sugieren que hasta un 40% del tiempo de postproducción en flujos de trabajo puramente generativos se dedica a intentar parchear estas inconsistencias, un coste que ninguna productora debería asumir.
Plataformas como Domer integran decenas de modelos bajo una interfaz unificada, lo que facilita combinar lo mejor de cada uno. Por ejemplo, se puede usar un modelo experto en movimiento para la animación y otro especializado en texturas para los detalles finales, todo sin perder el hilo visual. El resultado es una producción más rápida y con calidad cinematográfica.
Domer ofrece un generador de vídeo por IA y un generador de imágenes por IA que permiten experimentar con estas técnicas de forma práctica. También cuenta con modelos como Kling 3.0 o Seedance 2.0, cada uno con sus propias fortalezas. La clave está en no limitarse a un solo motor, sino en aprender a orquestarlos.
Cómo funciona la fusión de imágenes multi-IA
La fusión de imágenes multi-IA se apoya en la capacidad de los sistemas modernos para gestionar y correlacionar datos generados por arquitecturas de modelos fundamentalmente diferentes. Esto requiere un entendimiento profundo de cómo cada modelo codifica y decodifica la información visual y semántica.
Embeddings y anclaje de identidad
Los embeddings son vectores numéricos que capturan la semántica visual de una imagen. Al fusionar imágenes de referencia en un único espacio vectorial, el sistema puede comparar y transferir la identidad entre modelos con lenguajes internos completamente distintos. La segmentación semántica avanzada permite aislar al personaje del fondo y construir un perfil vectorial único. Ese perfil actúa como un pasaporte que el personaje lleva consigo a través de los diferentes ecosistemas de generación.
Una buena práctica es construir un perfil de embeddings con varias vistas del personaje: frontal, perfil y tres cuartos. Esto hace que el anclaje sea mucho más robusto que con una sola fotografía. La gestión de la iluminación y las oclusiones también es crítica: hay que compensar las distintas suposiciones de renderizado de cada motor para evitar sombras inconsistentes o brillos extraños.
Orquestación de modelos
No basta con tener varios modelos; hace falta una capa que los coordine. Una arquitectura modular, con una clara separación de responsabilidades entre los adaptadores de cada modelo, permite seleccionar el motor más adecuado para cada tarea. Si una escena requiere movimiento fluido, se elige un modelo especializado en vídeo; si lo que importa es el detalle estático, quizá un modelo de imagen sea mejor opción.
La normalización de entradas también es esencial. Antes de pasar una imagen de referencia a un modelo como Kling 2.6, es necesario transformar los metadatos al formato que ese modelo espera. Solo así se puede mantener el control de estilo a lo largo de todo el pipeline. La gestión del cola de tareas (task queue) es vital para repartir la carga de GPU y asegurar que las peticiones complejas no colapsen el servicio, manteniendo tiempos de respuesta predecibles.
Control de fotogramas clave
Uno de los métodos más efectivos para garantizar la consistencia es el control explícito de fotogramas clave. En lugar de depender únicamente de la prompt, el creador define secuencias de control visualmente ricas: varias imágenes del personaje en poses y ángulos distintos. Esas imágenes se convierten en puntos de anclaje entrenables.
Cuando el personaje debe pasar de una escena generada con un modelo a otra generada con un modelo diferente, el sistema interpola de forma semántica entre los fotogramas clave definidos en ambos lados. Se aplica además un pintado condicional (inpainting) sobre las transiciones para que, si el fondo cambia drásticamente, el personaje se mantenga fijo en su pose y textura, adaptándose al nuevo entorno sin romperse. La interfaz de usuario debe abstraer esta complejidad, permitiendo arrastrar y soltar keyframes y especificar la tolerancia de deriva permitida entre tomas.
Técnicas avanzadas para mantener la consistencia
La verdadera maestría en la edición de vídeo avanzada reside en la habilidad técnica para hacer que modelos dispares trabajen juntos sin fisuras. Esto requiere técnicas específicas de manipulación de outputs e inputs generados por IA.
Mapeo de características entre modelos
Cuando se combinan dos modelos tan distintos como uno centrado en el movimiento y otro especializado en texturas, es necesario un mapeo riguroso de características. Se aíslan los vectores de movimiento y la estructura espacial de la salida del primer modelo y se fuerzan sobre el espacio latente del segundo.
Los mapas de profundidad y las normales extraídas del vídeo de origen permiten imponer una geometría consistente al nuevo modelo, que se encarga de rellenar los detalles estilísticos. También se puede utilizar una red de adaptación estilística que aprende las diferencias sistemáticas entre ambos dominios, logrando una transformación suave en lugar de un salto brusco. La evaluación perceptual en tiempo real, utilizando algoritmos como SSIM o VMAF adaptados para IA, verifica si el resultado cumple con los umbrales de coherencia establecidos antes de pasar a la siguiente etapa.
Modelos auxiliares para corrección
A menudo el modelo principal genera un movimiento excelente pero falla en la física sutil o en la textura de materiales complejos. Aquí entran en juego los modelos especializados. La fusión multi-IA implica encadenar varios motores en serie: el modelo principal produce la primera versión y un modelo auxiliar refina las zonas problemáticas.
Por ejemplo, un modelo experto en coherencia temporal puede eliminar el parpadeo (flickering) que los modelos más grandes pasan por alto. Otro modelo puede actuar como un "pincel" para retexturizar áreas concretas sin alterar el resto de la imagen. Esta especialización es más eficiente que intentar que un único modelo gigante lo haga todo perfectamente, y permite optimizar los recursos de cómputo disponibles.
Métricas de evaluación
Para saber si la fusión está funcionando, no basta con mirar la imagen. Hacen falta métricas objetivas que comparen los embeddings del personaje entre tomas, como la distancia euclidiana o la similitud coseno. Si la distancia supera un umbral, el sistema puede sugerir ajustes en los prompts, cambiar de modelo base o reforzar la imagen de referencia. Estas métricas también permiten auditar el proceso y mejorar iteración tras iteración.
Flujo de trabajo profesional paso a paso
Para llevar estas técnicas a la práctica, conviene seguir un flujo de trabajo estructurado:
- Definir la identidad: generar un set inicial de imágenes de referencia del personaje, incluyendo distintas poses y expresiones.
- Construir el perfil de embeddings: extraer los vectores característicos y guardarlos como un asset reutilizable.
- Planificar las escenas: decidir qué modelo se usará para cada toma y qué fotogramas clave servirán como puente entre ellas.
- Generar con restricciones: alimentar cada modelo con la imagen de referencia y los parámetros de consistencia definidos.
- Evaluar y refinar: comparar las salidas con métricas de similitud estructural y corregir las desviaciones con modelos auxiliares.
- Documentar la trazabilidad: registrar qué modelo generó cada parte del vídeo, con qué parámetros y qué referencia se utilizó.
Persistencia y trazabilidad
En proyectos largos, es fundamental guardar los perfiles de consistencia en una base de datos que permita consultarlos en cualquier momento. Un repositorio centralizado de embeddings garantiza que la identidad del personaje se recupere con precisión aunque haya pasado tiempo entre sesiones de creación. La trazabilidad también es importante: saber qué modelo generó cada plano ayuda a reproducir resultados y a evitar sorpresas en la postproducción.
Distribución eficiente
Una vez que la secuencia fusionada está aprobada, debe entregarse rápidamente. Una red de distribución de contenidos (CDN) asegura que las imágenes de referencia se carguen casi instantáneamente al iniciar una nueva generación, minimizando la latencia. Esto es especialmente útil en equipos que colaboran de forma remota o que necesitan iterar con rapidez.
Errores comunes y cómo evitarlos
Uno de los errores más habituales es confiar en una única imagen de referencia. Si el personaje solo tiene una vista frontal, cualquier cambio de ángulo provocará una pérdida de identidad. La solución es crear un set de referencia completo desde el principio.
Otro error es mezclar modelos sin normalizar las entradas. Cada motor tiene su propia forma de interpretar los prompts y las imágenes; alimentarlos con datos en formatos distintos solo genera ruido. La normalización es una inversión que ahorra horas de corrección.
Por último, muchos creadores ignoran las métricas de evaluación. Sin una medición objetiva de la similitud entre tomas, la consistencia se convierte en un juego de adivinanzas. Incorporar métricas automáticas al flujo de trabajo es la diferencia entre un proyecto profesional y un experimento amateur.
Conclusión
La fusión de imágenes multi-IA es la respuesta al problema más irritante de la generación de vídeo con inteligencia artificial: la inconsistencia visual. Con las técnicas adecuadas —embeddings de referencia, orquestación de modelos, fotogramas clave y mapeo de características— es posible producir contenido de calidad cinematográfica manteniendo personajes reconocibles a lo largo de toda la narrativa.
Herramientas como el generador de vídeo con IA, el generador de imágenes con IA y modelos de última generación como GPT Image 2 y Kling 3.0 ponen estas técnicas al alcance de cualquier creador. El futuro de la edición de vídeo ya está aquí: solo hay que aprender a orquestar todas las piezas del rompecabezas.
